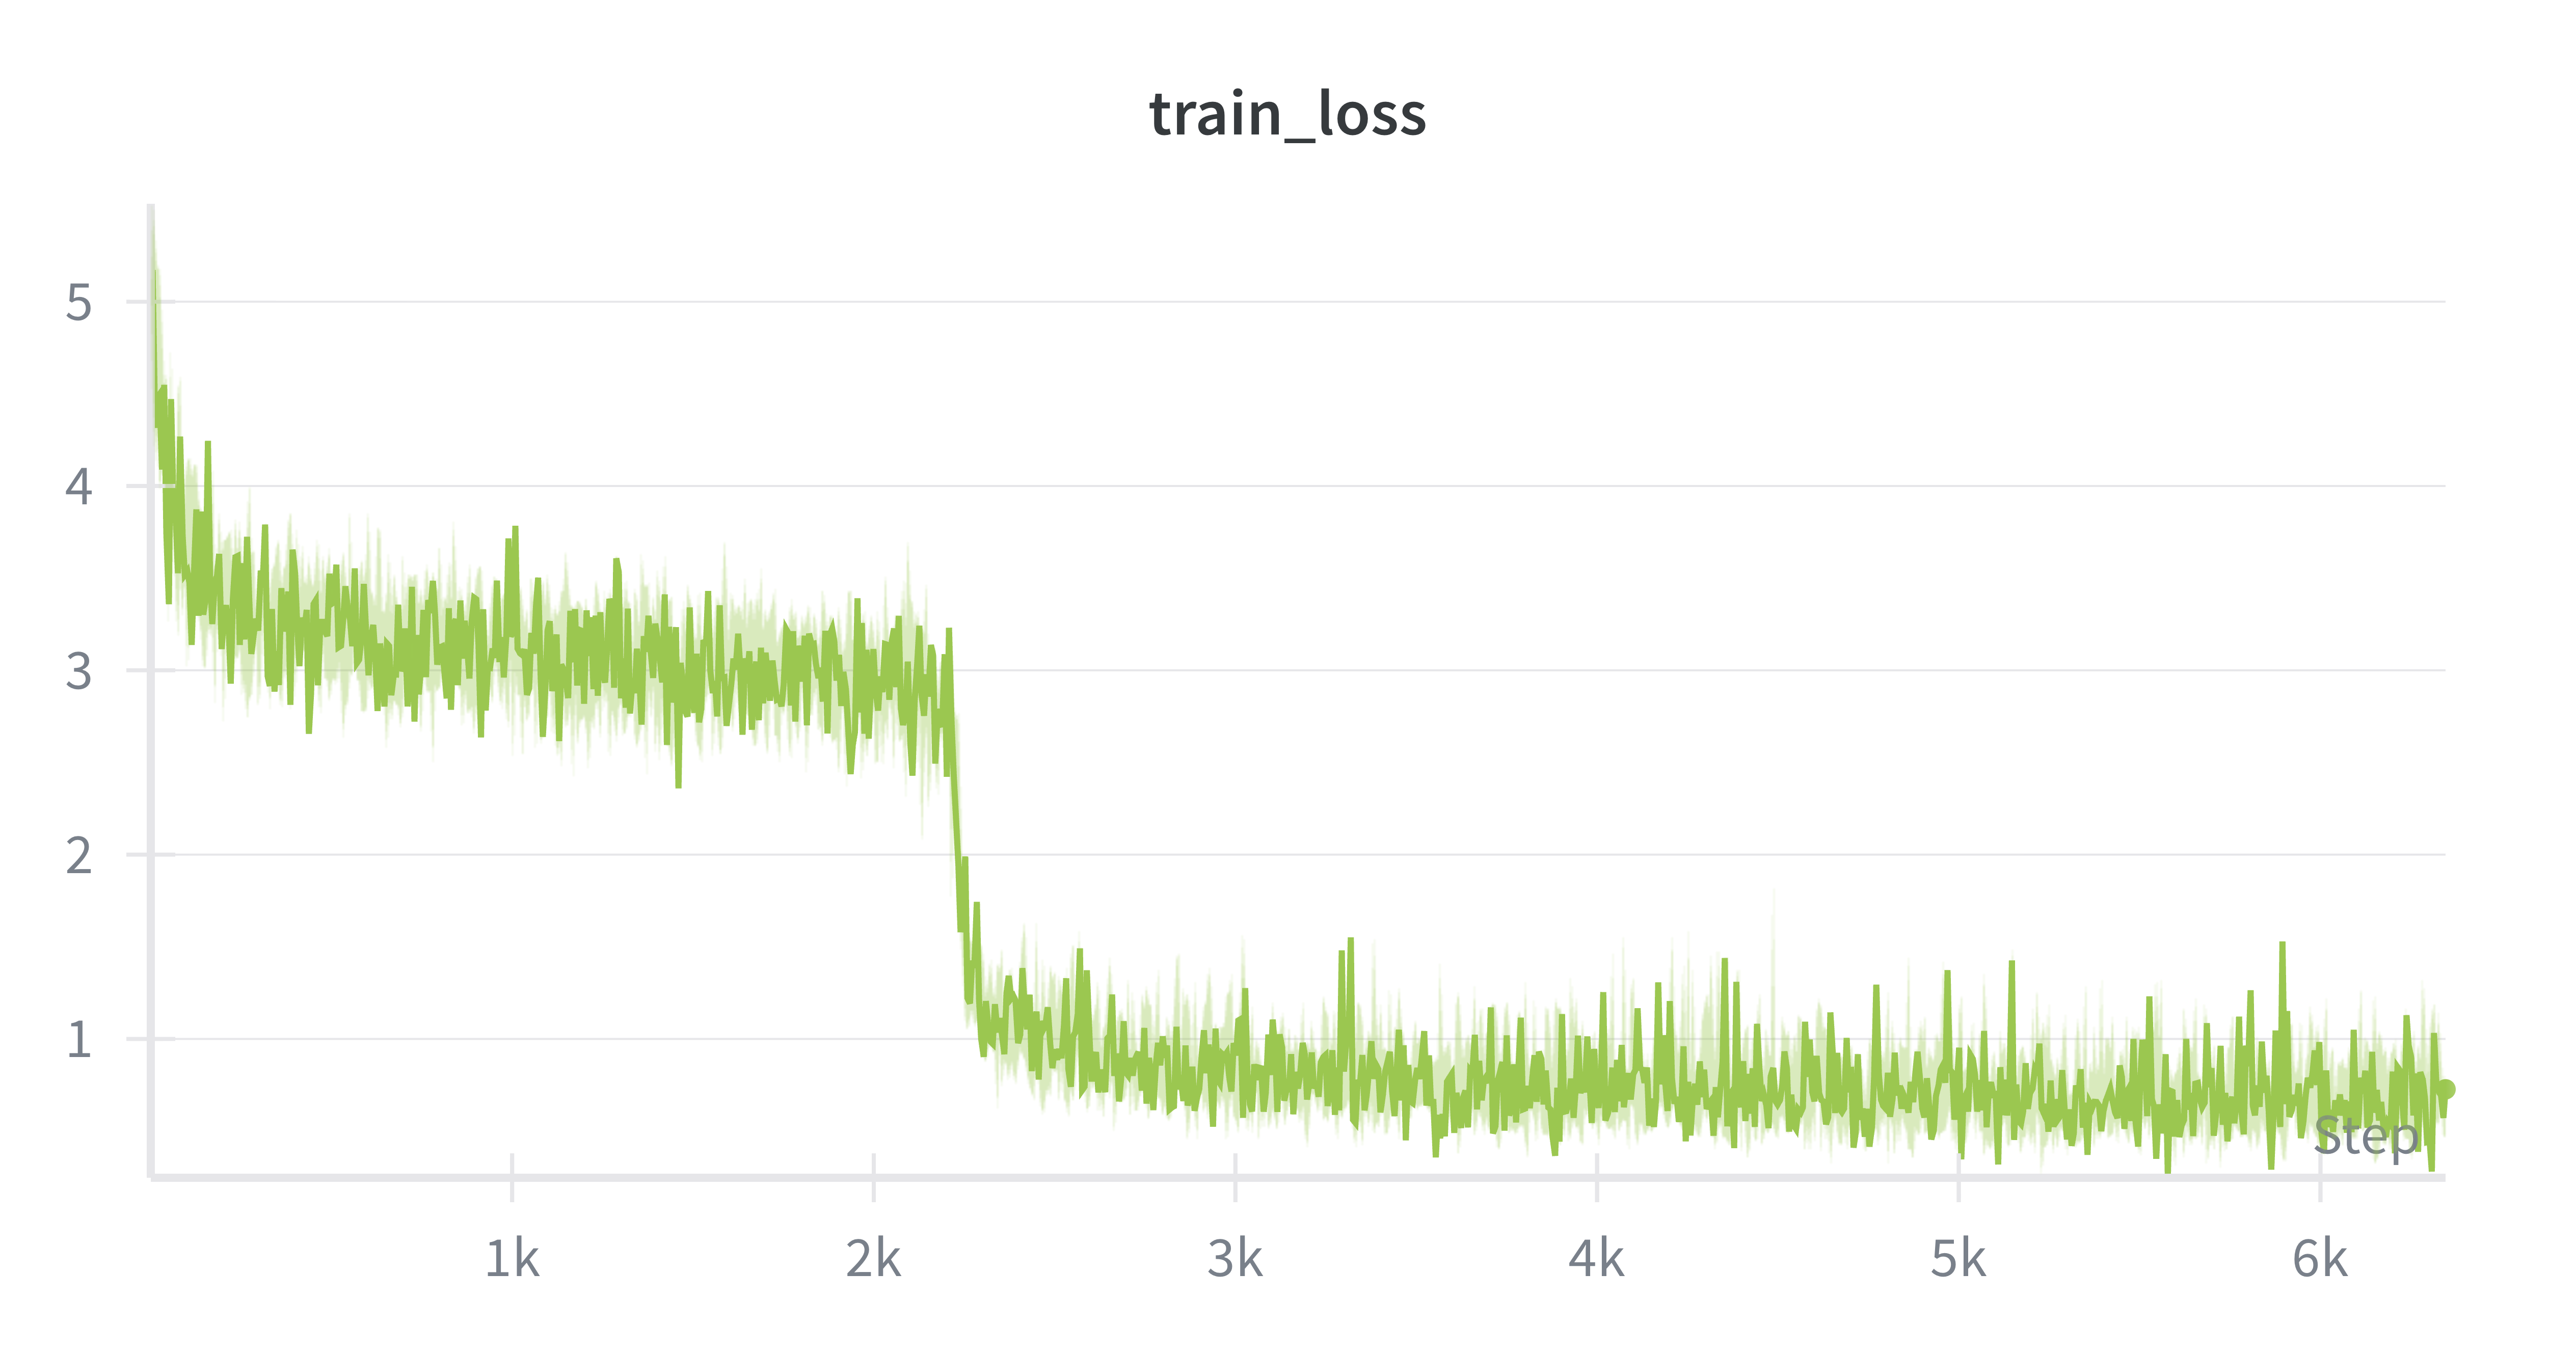
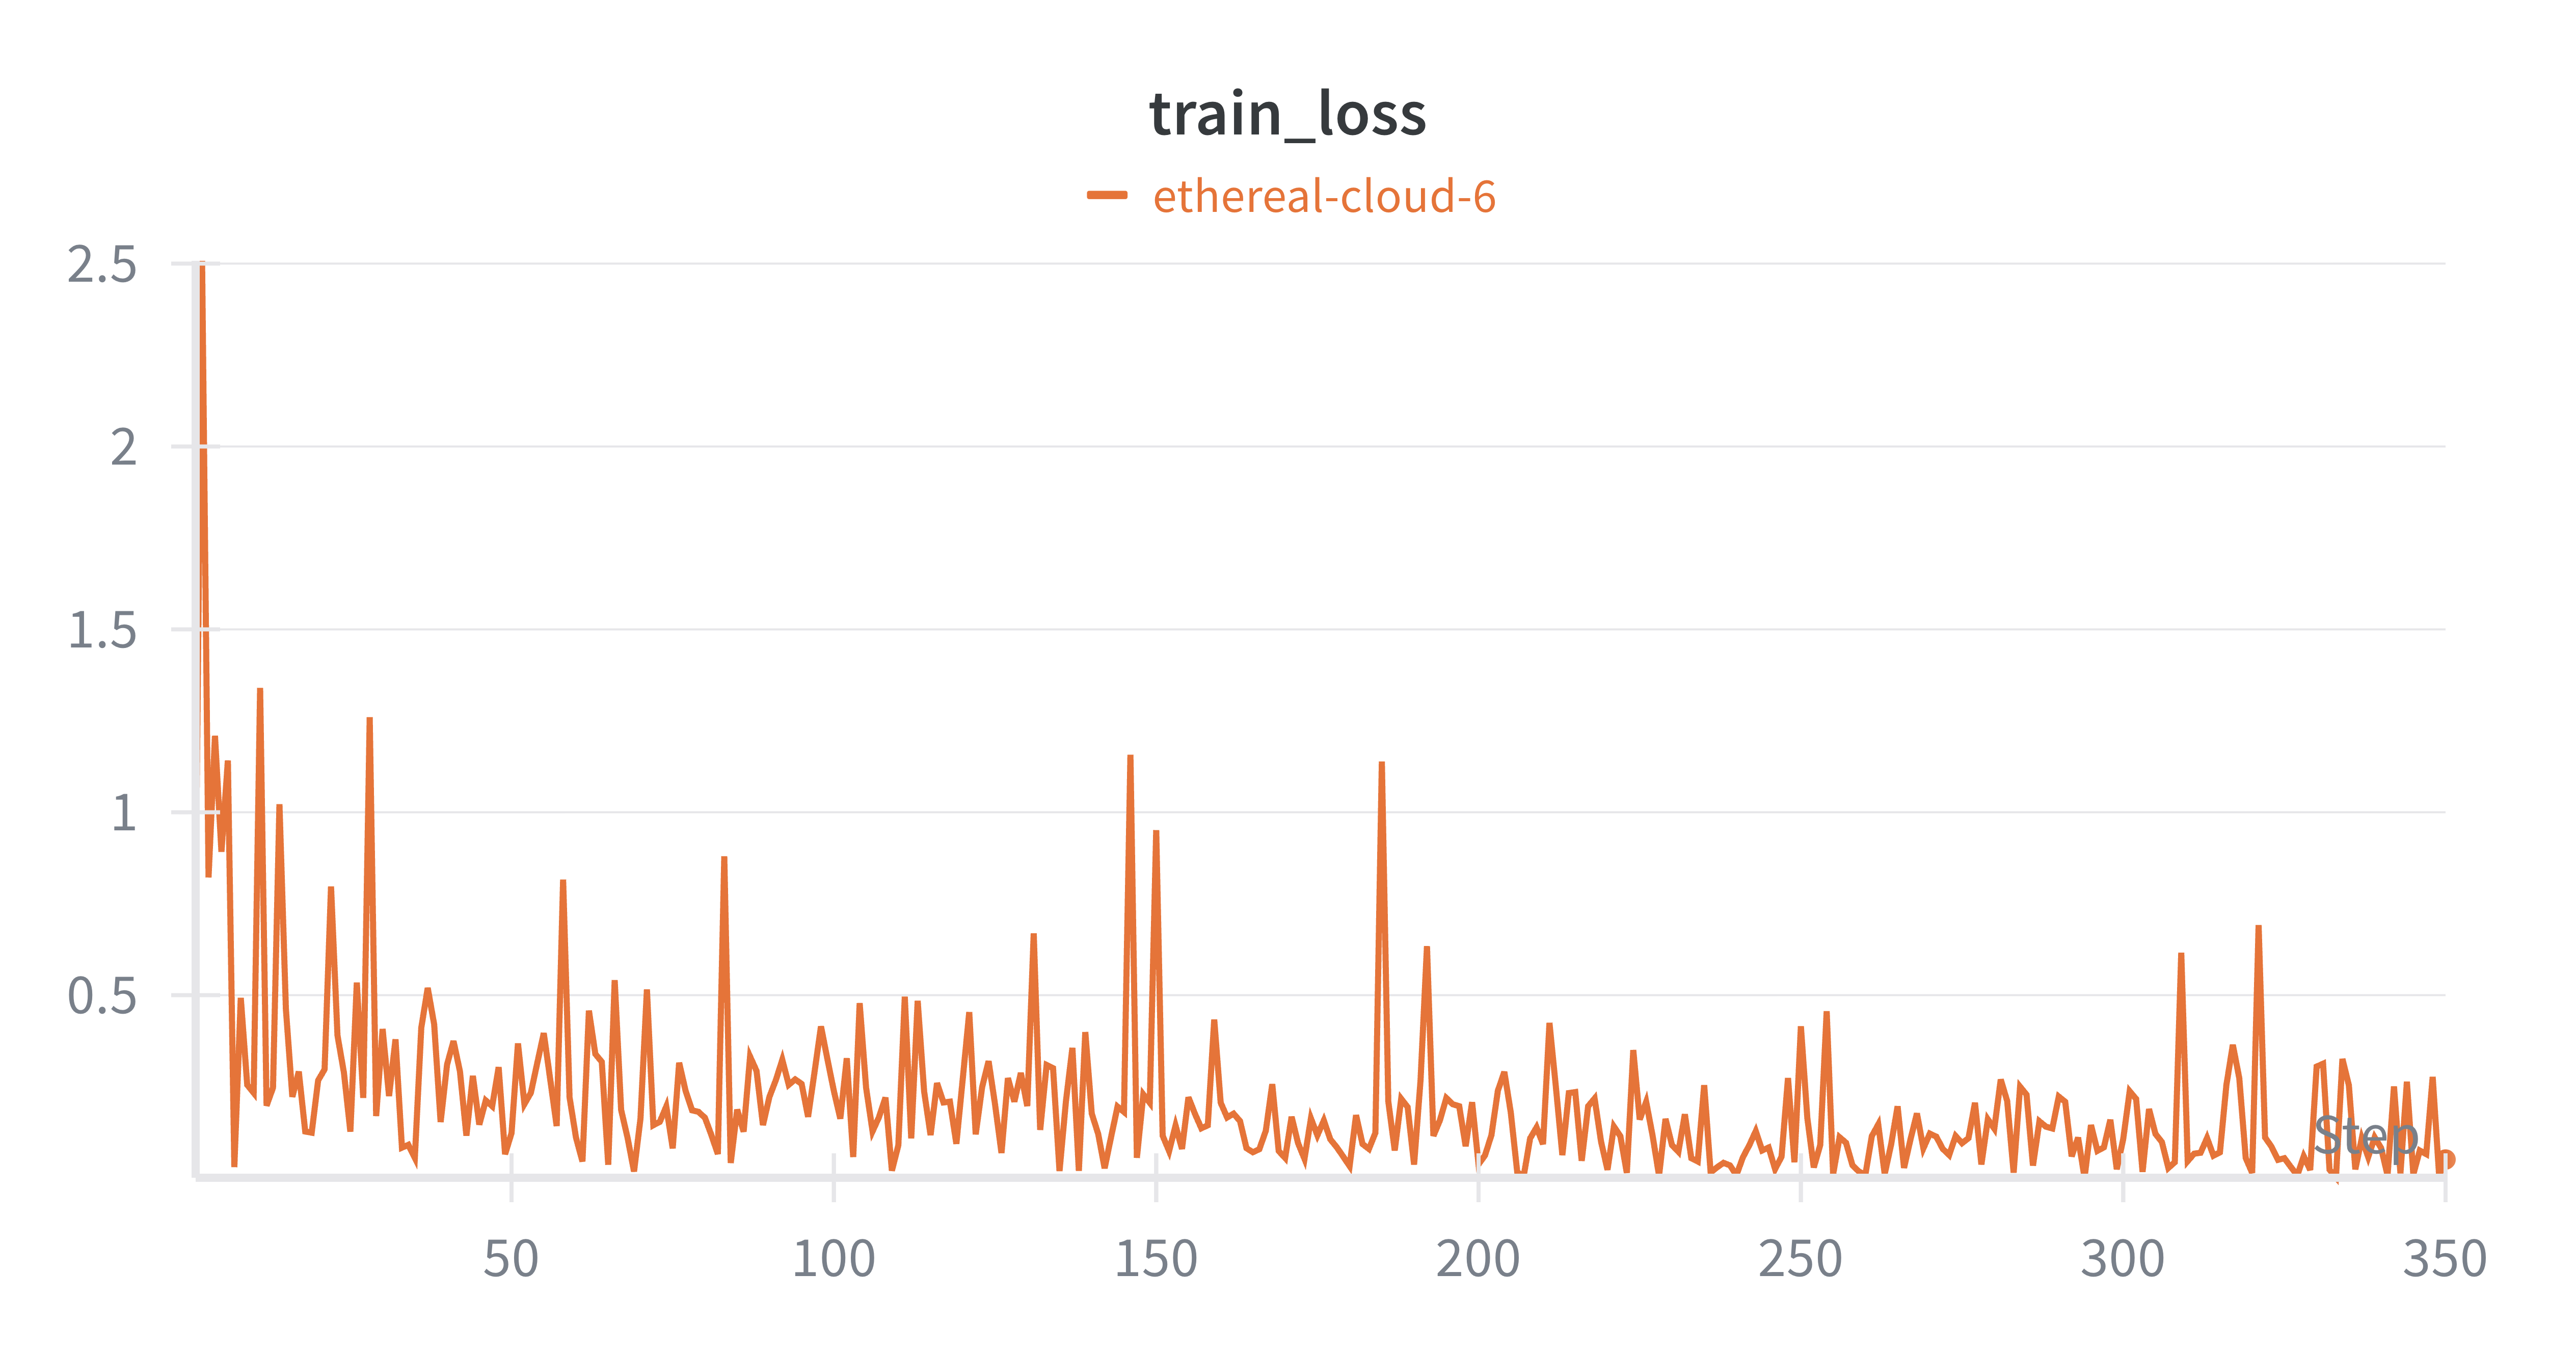
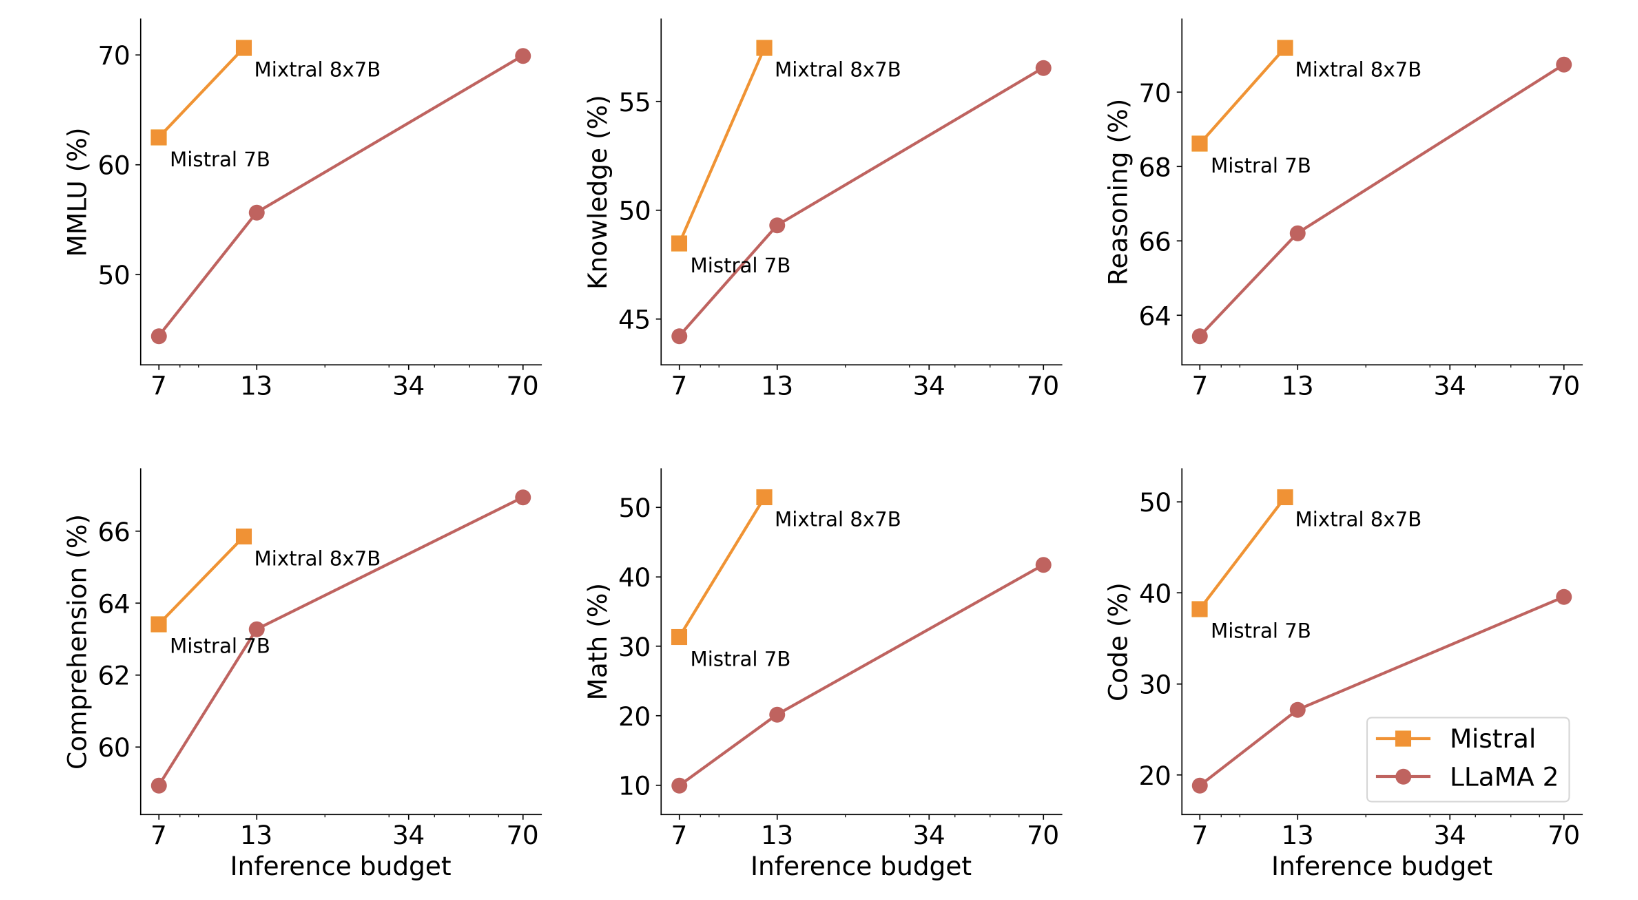
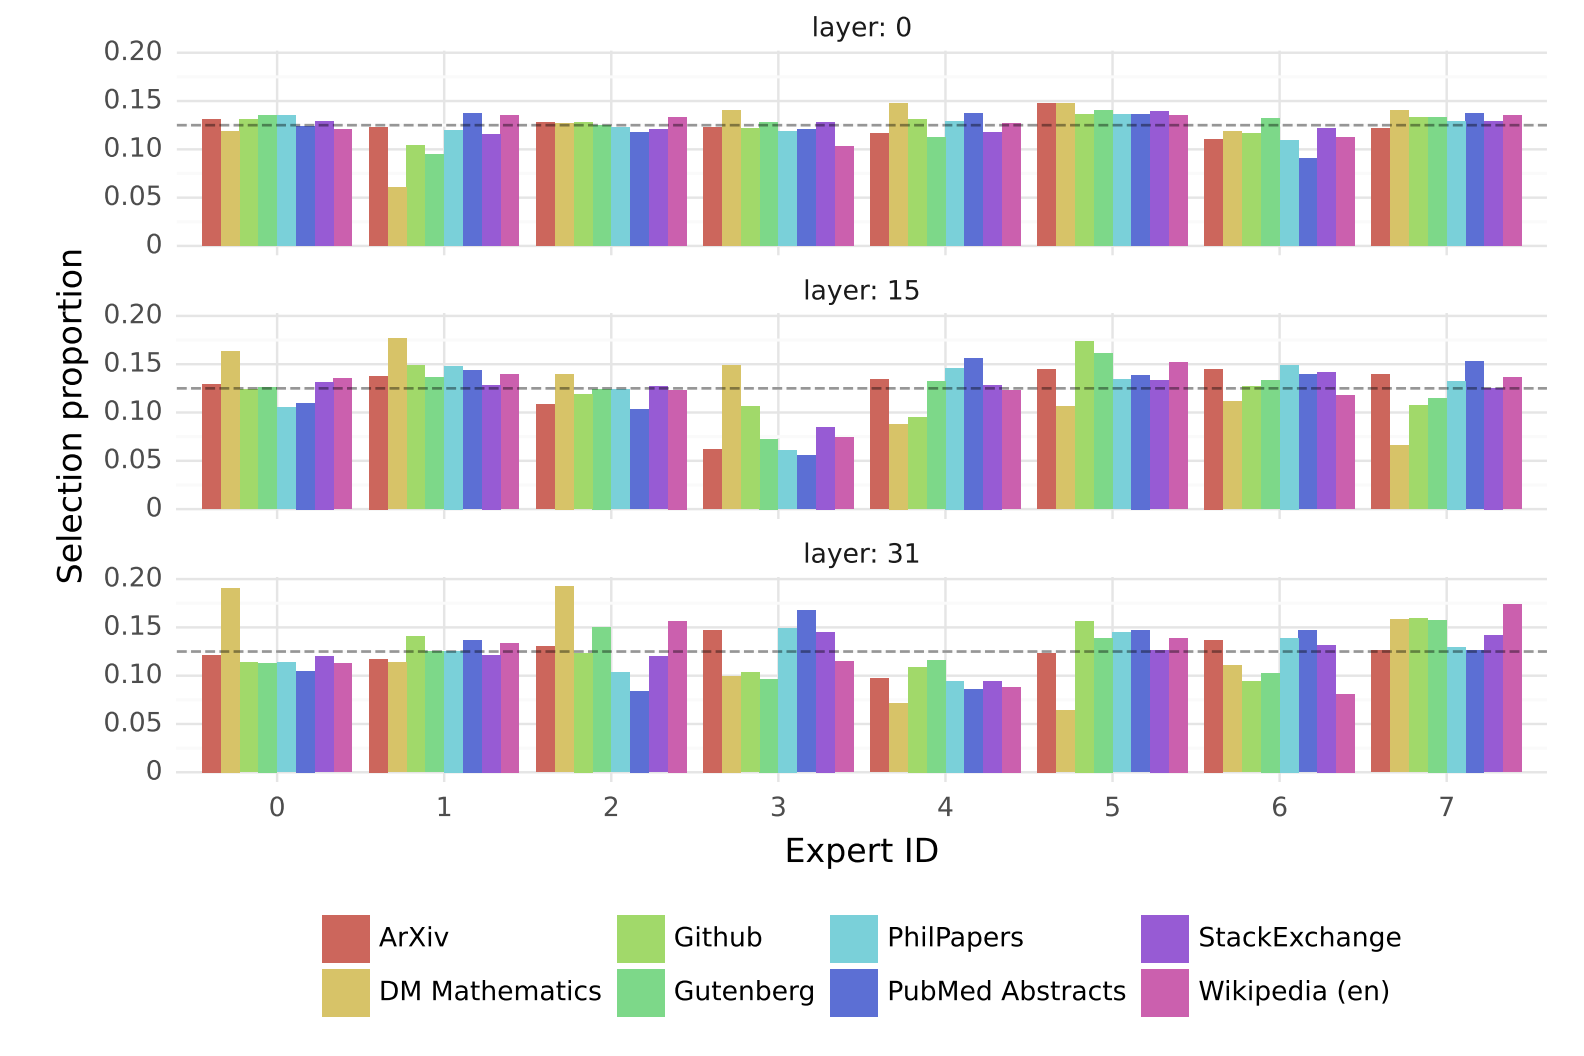
<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="ko"><generator uri="https://jekyllrb.com/" version="4.4.1">Jekyll</generator><link href="https://seungyounshin.github.io/feed.xml" rel="self" type="application/atom+xml"/><link href="https://seungyounshin.github.io/" rel="alternate" type="text/html" hreflang="ko"/><updated>2026-09-06T11:30:57+09:00</updated><id>https://seungyounshin.github.io/feed.xml</id><title type="html">Seungyoun Shin(신승윤)</title><subtitle>AI Research Engineer at Upstage. Long-horizon agentic RL and agent environments. </subtitle><entry><title type="html">다음에 뭘 할까 — 2026 하반기 연구 노트</title><link href="https://seungyounshin.github.io/blog/2026/whats-next/" rel="alternate" type="text/html" title="다음에 뭘 할까 — 2026 하반기 연구 노트"/><published>2026-08-02T00:00:00+09:00</published><updated>2026-08-02T00:00:00+09:00</updated><id>https://seungyounshin.github.io/blog/2026/whats-next</id><content type="html" xml:base="https://seungyounshin.github.io/blog/2026/whats-next/"><![CDATA[<h2 id="이-글을-쓰는-이유">이 글을 쓰는 이유</h2> <p>연구를 하다 보면 “지금 뭘 하고 있냐”는 질문에 답하기는 쉬운데, “왜 그걸 하고 있냐”에 답하기는 어렵다. 전자는 캘린더를 보면 되고, 후자는 몇 달 전의 판단을 다시 꺼내야 하기 때문이다.</p> <p>그래서 앞으로는 이 블로그에 <strong>결정의 이유</strong>를 남겨두려고 한다. 논문으로 정리되기 전, 아직 틀렸을 수도 있는 상태의 생각들. 반년 뒤에 다시 읽었을 때 어디서 틀렸는지 보이는 게 목적이다.</p> <hr/> <h2 id="지금까지-만든-것들">지금까지 만든 것들</h2> <p>돌아보면 지난 몇 년의 작업은 서로 달라 보이지만 한 축을 공유한다. <strong>정답이 명확하지 않은 문제에서 어떻게 학습 신호를 만들 것인가.</strong></p> <ul> <li> <p><a href="/blog/2026/sori-speech-llm/">소리(Sori)</a> — Qwen3-4B에 audio encoder를 붙여 한국어 speech LLM을 만들었다. Encoder와 LLM은 frozen, projection layer만 학습. 여기서의 신호는 transcription이라 깔끔했다. 정답이 있으니까.</p> </li> <li> <p><strong>No Verifiable Reward for Prosody</strong> (ICASSP 2026) — 반대의 경우. 운율에는 검증 가능한 정답이 없다. 그래서 preference로 갔다. “정답이 없으면 선호로 대체한다”는 게 이 논문의 전부였고, 지금 생각하면 그게 가장 중요한 부분이었다.</p> </li> <li> <p><strong>KoALa-Bench</strong> — 한국어 audio LM을 평가하려면 먼저 무엇을 잴지 정해야 했다. faithfulness를 따로 뺀 이유가 여기 있다.</p> </li> <li> <p><strong>Solar Open 2</strong> (<a href="https://arxiv.org/abs/2607.20062">arXiv:2607.20062</a>) — 250B-A15B MoE, 1M context, long-horizon agentic task를 위해 만든 모델. 열두 개의 domain specialist를 학습시킨 뒤 Multi-teacher On-Policy Distillation(MOPD)으로 하나의 모델에 합쳤다.</p> </li> </ul> <p>마지막 항목이 지금 내 관심사를 대부분 설명한다. MOPD는 결국 <strong>teacher가 여럿일 때 on-policy로 신호를 합치는 방법</strong>이고, prosody 논문은 <strong>신호가 아예 없을 때 선호로 만드는 방법</strong>이었다. 둘 다 “reward를 어디서 가져올 것인가”라는 같은 질문의 다른 답이다.</p> <hr/> <h2 id="남은-질문-세-개">남은 질문 세 개</h2> <h3 id="1-long-horizon에서-credit-assignment는-어떻게-하나">1. Long-horizon에서 credit assignment는 어떻게 하나</h3> <p>1M context는 에이전트의 trajectory 전체를 한 컨텍스트에 넣을 수 있게 해줬다. 그런데 넣을 수 있다는 것과 그로부터 배울 수 있다는 것은 다르다.</p> <p>수백 스텝짜리 trajectory가 최종적으로 실패했을 때, 어느 스텝이 문제였는지를 outcome reward 하나로 역전파하는 건 신호 대 잡음비가 너무 나쁘다. Process reward를 붙이면 나아지지만, 이번엔 process reward를 누가 만드는가의 문제가 돌아온다.</p> <blockquote> <p>지금 생각: on-policy distillation이 여기서 답이 될 수 있다. Teacher가 같은 상태에서 무엇을 했을지가 곧 스텝 단위 신호이기 때문이다. 아직 확신은 없다.</p> </blockquote> <h3 id="2-self-distillation은-어디서-멈추나">2. Self-distillation은 어디서 멈추나</h3> <p>모델이 자기 출력으로 자기를 학습시킬 때, 어느 시점부터는 자기 편향을 증폭하기 시작한다. MOPD처럼 teacher가 여럿이면 이 문제가 완화되는데, 왜 완화되는지를 나는 아직 정확히 설명하지 못한다.</p> <p>Teacher 다양성이 정규화 역할을 하는 것인지, 아니면 단순히 앙상블 효과인지. 이 둘은 예측이 다르다. 전자가 맞으면 teacher를 일부러 서로 다르게 만들어야 하고, 후자가 맞으면 그냥 개수를 늘리면 된다.</p> <h3 id="3-환경이-현실과-다르면-정확히-무엇이-무너지나">3. 환경이 현실과 다르면 정확히 무엇이 무너지나</h3> <p>이게 요즘 가장 많이 생각하는 문제다.</p> <p>Long-horizon agentic RL에서 병목은 알고리즘보다 <strong>환경</strong>인 경우가 많다. 벤치마크용으로 깎아둔 태스크에서 잘하는 정책이 실제 사무 업무에서는 바로 무너지는데, 그 간극이 어디서 생기는지가 명확하지 않다.</p> <p>실제 사무 업무에는 벤치마크가 대개 생략하는 것들이 있다. 지시가 불완전하고, 중간에 바뀌고, 도구가 실패하고, 되돌릴 수 없는 행동이 섞여 있고, 무엇보다 “다 했다”의 기준이 사람마다 다르다. 이 중 어떤 걸 빼면 학습된 정책이 얼마나 망가지는지를 나는 아직 모른다.</p> <blockquote> <p>지금 생각: 환경을 현실에 가깝게 만드는 걸 데이터 수집이 아니라 <strong>연구 자체</strong>로 다뤄야 한다. 환경이 곧 reward의 정의이기 때문이다. 질문 1의 credit assignment도 결국 환경이 무엇을 관측 가능하게 해주느냐에 달려 있다.</p> </blockquote> <hr/> <h2 id="앞으로-6개월">앞으로 6개월</h2> <p>한 문장으로 줄이면 — <strong>사무 업무를 충분히 현실적으로 재현하는 에이전트 환경을 만들고, 거기서 끝까지 학습시켜 보는 것.</strong></p> <p>세 질문이 여기서 만난다. 환경이 있어야 스텝 단위 신호를 관측할 수 있고(질문 1), 환경이 다양해야 teacher를 의미 있게 분산시킬 수 있고(질문 2), 그 다양성이 실제로 무엇을 지탱하는지는 환경을 깎아봐야 안다(질문 3).</p> <p>순서는 이렇게 잡고 있다.</p> <ol> <li><strong>환경 먼저.</strong> 벤치마크가 생략하는 것들 — 불완전한 지시, 도중에 바뀌는 요구사항, 실패하는 도구, 되돌릴 수 없는 행동 — 을 일부러 넣은 태스크를 만든다.</li> <li><strong>그 위에서 진단.</strong> 실패한 trajectory에서 어느 스텝이 문제였는지 볼 수 있는 세팅을 붙인다. 학습보다 관측이 먼저다.</li> <li><strong>그다음 학습.</strong> 여기서 비로소 질문 2를 실험으로 가른다. teacher를 의도적으로 분산시킨 조건과 개수만 늘린 조건을 비교한다.</li> </ol> <p>어느 정도까지 공개할 수 있을지는 아직 정리 중이라, 구체적인 태스크 구성이나 수치는 나중에 따로 적겠다.</p> <hr/> <h2 id="어떻게-알-수-있나">어떻게 알 수 있나</h2> <p>이런 글은 대개 틀린다. 그래서 틀렸다는 걸 알 수 있게 기준을 적어둔다.</p> <ul> <li>6개월 뒤에도 환경 위에서 스텝 단위 기여도를 못 보고 있다면 — 우선순위를 잘못 잡은 것이다.</li> <li>만든 환경에서 잘하는 정책이 실제 업무에서 여전히 무너진다면 — 빠뜨린 축이 있는 것이고, 그게 무엇인지가 다음 질문이 된다.</li> <li>teacher 다양성 실험이 “차이 없음”으로 나온다면 — 질문 2의 전제가 틀린 것이고, self-distillation을 보는 관점을 바꿔야 한다.</li> </ul> <p>다음 글에서 하나씩 확인하겠다.</p>]]></content><author><name>신승윤</name></author><category term="research-notes"/><category term="rl"/><category term="agents"/><summary type="html"><![CDATA[지금까지 만든 것들에서 남은 질문을 추리고, 앞으로 붙잡을 문제를 정리한다.]]></summary></entry><entry><title type="html">소리(Sori): LLM에게 귀를 달아주는 이야기</title><link href="https://seungyounshin.github.io/blog/2026/sori-speech-llm/" rel="alternate" type="text/html" title="소리(Sori): LLM에게 귀를 달아주는 이야기"/><published>2026-02-16T00:00:00+09:00</published><updated>2026-02-16T00:00:00+09:00</updated><id>https://seungyounshin.github.io/blog/2026/sori-speech-llm</id><content type="html" xml:base="https://seungyounshin.github.io/blog/2026/sori-speech-llm/"><![CDATA[<h2 id="시작하며">시작하며</h2> <p>한국어 Speech LLM을 처음부터 만든다고 했을 때, <strong>데이터는 얼마나 필요할까? 훈련 다이나믹스는 어떻게 될까?</strong> 이게 이 프로젝트를 시작한 가장 큰 이유였다.</p> <p>요즘 LLM에 음성 입력을 붙이는 것 자체는 이미 많은 시도가 있다. GPT-4o, Gemini 등 상용 모델들도 음성을 지원하고, 오픈소스 쪽에서도 다양한 Speech LLM이 나오고 있다. 하지만 대부분 영어 중심이고, 한국어에서의 훈련 경험을 공유하는 경우는 드물다.</p> <p>그래서 직접 해보기로 했다. 설날 연휴에 H100 8대를 잡고, Qwen3-4B에 귀를 달아주는 실험을 진행했다. <strong>한국어 음성 410만 샘플로 alignment를 시키면 어떤 loss 곡선이 나오는지, 얼마나 빠르게 수렴하는지</strong> — 이런 감을 잡고 싶었다.</p> <p>그래서 만든 게 <strong>소리(Sori)</strong>다. 한국어로 “소리”. 거창한 건 없다.</p> <h2 id="encoder-adapter-llm-패러다임">Encoder-Adapter-LLM 패러다임</h2> <p>Speech LLM을 만드는 핵심 아이디어는 놀라울 정도로 단순하다.</p> <div class="highlight-box"> <p>이미 잘 훈련된 <strong>Audio Encoder</strong>가 있고, 이미 잘 훈련된 <strong>LLM</strong>이 있다. 이 둘을 연결하는 <strong>작은 Adapter(Projection Layer)</strong>만 학습시키면 된다.</p> </div> <p>이 접근은 사실 새로운 게 아니다. Vision 쪽에서 <a href="https://arxiv.org/abs/2304.08485">LLaVA</a>가 CLIP Vision Encoder와 LLM 사이에 Linear Projection 하나를 두고, <strong>Encoder와 LLM은 Frozen한 채로 Projection만 학습</strong>시켜서 Visual Instruction Following을 가능하게 한 것과 같은 패러다임이다. Audio 쪽에서는 <a href="https://arxiv.org/abs/2407.10759">Qwen2-Audio</a>가 Whisper Encoder와 Qwen LLM 사이에 Linear Projection을 두는 구조를 사용했다 (다만 Qwen2-Audio는 Stage 1에서 Encoder까지 fine-tuning한다는 차이가 있다).</p> <p>Sori는 LLaVA의 Stage 1과 동일한 전략을 따른다: <strong>Encoder와 LLM 모두 Frozen, Projection Layer만 학습</strong>. 이걸 한국어 음성 도메인에 적용한 것이다.</p> <p>이건 마치 한국어를 잘하는 사람과 영어를 잘하는 사람 사이에 <strong>통역사 한 명</strong>을 두는 것과 같다. 통역사만 잘 훈련시키면 둘이 자유롭게 소통할 수 있다.</p> <h2 id="아키텍처">아키텍처</h2> <p>Sori의 구조는 다음과 같다:</p> <div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Audio (16kHz 한국어 음성)
    ↓
Mel Spectrogram (128 bins)
    ↓
Audio Encoder (647M params) ← Qwen3-Omni AuT, Frozen
    ↓
audio_proj MLP (12M params) ← 이것만 학습!
    ↓
Qwen3-4B-Instruct (4B params) ← Frozen (Stage 1) / LoRA (Stage 2)
    ↓
텍스트 출력 or Tool Call
</code></pre></div></div> <table> <thead> <tr> <th style="text-align: left">컴포넌트</th> <th style="text-align: center">파라미터</th> <th style="text-align: left">역할</th> <th style="text-align: center">학습 여부</th> </tr> </thead> <tbody> <tr> <td style="text-align: left">Audio Encoder</td> <td style="text-align: center">647M</td> <td style="text-align: left">음성 → 벡터 변환</td> <td style="text-align: center">Frozen</td> </tr> <tr> <td style="text-align: left">audio_proj</td> <td style="text-align: center"><strong>12M</strong></td> <td style="text-align: left">음성 벡터 → LLM 입력 공간 변환</td> <td style="text-align: center"><strong>학습</strong></td> </tr> <tr> <td style="text-align: left">Qwen3-4B</td> <td style="text-align: center">4B</td> <td style="text-align: left">언어 이해 및 생성</td> <td style="text-align: center">Stage에 따라 다름</td> </tr> </tbody> </table> <p><strong>audio_proj</strong>는 겨우 12M 파라미터다. 전체 모델의 약 <strong>0.25%</strong>. 2-layer MLP로 <code class="language-plaintext highlighter-rouge">2048 → 2560 → 2560</code> 차원 변환을 해준다. 이 작은 다리 하나가 소리와 언어를 연결해준다.</p> <p>Audio Encoder는 <a href="https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Instruct">Qwen3-Omni</a>의 Audio Transformer를 그대로 가져왔다. 7M 시간 이상의 오디오로 사전학습된 모델이라 음성 표현력이 이미 충분하다. LLM은 <a href="https://huggingface.co/Qwen/Qwen3-4B-Instruct-2507">Qwen3-4B-Instruct</a>를 썼다.</p> <p>한 가지 삽질한 점이 있는데, Mel Spectrogram을 추출할 때 <strong>반드시 Qwen3-Omni의 WhisperFeatureExtractor와 동일한 설정</strong>을 써야 한다. Slaney mel scale + log10 + normalization. torchaudio 기본 파라미터를 쓰면 미묘하게 다른 feature가 나와서 성능이 확 떨어진다. 이거 찾는데 시간 꽤 썼다.</p> <h2 id="stage-1-transcription으로-alignment">Stage 1: Transcription으로 Alignment</h2> <p>첫 번째 단계의 목표는 간단하다: <strong>한국어 음성을 텍스트로 전사(transcription)하는 태스크를 통해 audio_proj를 정렬(align)시키는 것</strong>이다. 입력은 한국어 음성, 출력은 해당 음성의 텍스트 전사. 이 단순한 태스크만으로도 audio_proj가 음성 공간과 LLM의 텍스트 공간 사이의 매핑을 학습한다.</p> <div class="stage-card"> <p><strong>Stage 1 — Alignment via Transcription</strong></p> <ul> <li>Audio Encoder: Frozen</li> <li>audio_proj: <strong>학습</strong> (12M params, 전체의 0.25%)</li> <li>LLM: Frozen</li> <li>Task: 한국어 음성 → 텍스트 전사</li> <li>데이터: 한국어 음성 410만 샘플</li> <li>Learning Rate: 1e-4</li> <li>Effective Batch Size: 1024 (8 GPU × 8 accumulation × 16)</li> <li>Steps: 6,000</li> <li>Hardware: 8× H100 80GB</li> </ul> </div> <p>학습 데이터는 총 <strong>410만 개</strong>의 한국어 음성-텍스트 쌍을 모았다:</p> <table> <thead> <tr> <th style="text-align: left">데이터셋</th> <th style="text-align: right">샘플 수</th> <th style="text-align: right">비율</th> </tr> </thead> <tbody> <tr> <td style="text-align: left">AIHub — 회의 음성</td> <td style="text-align: right">2.3M</td> <td style="text-align: right">56.3%</td> </tr> <tr> <td style="text-align: left">AIHub — 상담 음성</td> <td style="text-align: right">831K</td> <td style="text-align: right">20.0%</td> </tr> <tr> <td style="text-align: left">AIHub — 심층 인터뷰</td> <td style="text-align: right">802K</td> <td style="text-align: right">19.3%</td> </tr> <tr> <td style="text-align: left">Zeroth-STT-Korean</td> <td style="text-align: right">102K</td> <td style="text-align: right">2.5%</td> </tr> <tr> <td style="text-align: left">AIHub — 취업 면접</td> <td style="text-align: right">76K</td> <td style="text-align: right">1.8%</td> </tr> </tbody> </table> <p>의도적으로 다양한 도메인의 음성을 섞었다. 회의, 상담, 인터뷰… 사람들이 실제로 말하는 다양한 상황을 커버하고 싶었다. 회의 음성이 56%로 제일 많은데, 다수의 화자가 자연스럽게 대화하는 데이터라 모델이 실제 한국어 발화 패턴을 익히기에 좋았다.</p> <p>여기서 재밌는 점은, <strong>LLM 자체는 전혀 건드리지 않는다는 것</strong>이다. Qwen3-4B는 이미 “텍스트가 들어오면 텍스트를 출력한다”는 걸 완벽히 알고 있다. 우리는 audio_proj를 통해 “이 음성 벡터는 사실 이런 텍스트야”라고 LLM에게 알려주는 것뿐이다. LLM 입장에서는 그냥 텍스트 임베딩이 들어온 것처럼 느끼는 거다.</p> <h2 id="stage-2-음성-function-calling">Stage 2: 음성 Function Calling</h2> <p>Stage 1에서 모델이 한국어를 알아듣게 되었으니, 이제 한 단계 더 나아간다. <strong>한국어 음성이 들어오면 텍스트로 된 Tool Call을 출력</strong>하게 만드는 것이다.</p> <div class="stage-card"> <p><strong>Stage 2 — Function Calling (LoRA)</strong></p> <ul> <li>Audio Encoder: Frozen</li> <li>audio_proj: Frozen (Stage 1 결과 그대로)</li> <li>LLM: <strong>LoRA</strong> (r=16, alpha=32)</li> <li>Input: 한국어 음성</li> <li>Output: 텍스트 Tool Call</li> <li>데이터: 18K 한국어 FC 음성 샘플</li> <li>Epochs: 5</li> <li>Batch Size: 32</li> <li>Learning Rate: 2e-5</li> </ul> </div> <p>이 단계에서는 LLM에 <a href="https://arxiv.org/abs/2106.09685">LoRA</a>를 적용한다. 핵심은 <strong>assistant의 tool_call 토큰만 학습</strong>시킨다는 것이다. 사용자의 음성 부분이나 시스템 프롬프트 부분은 loss에서 제외하고, 오직 모델이 생성해야 하는 function call 부분만 학습한다.</p> <h3 id="fc-데이터셋-구축">FC 데이터셋 구축</h3> <p>Function Calling 학습 데이터는 다음과 같이 만들었다:</p> <div class="data-pipeline"> <span class="step step-source">Salesforce xLAM FC 데이터셋</span> → <span class="step step-process">한국어 번역</span> → <span class="step step-process">ElevenLabs TTS (10 화자)</span> → <span class="step step-result">18K 한국어 음성 FC 데이터</span> </div> <p><a href="https://huggingface.co/datasets/Seungyoun/xlam-function-calling-60k-audio-kor">Salesforce의 xLAM function-calling 데이터셋</a>에서 질의(question) 부분을 한국어로 번역한 뒤, <a href="https://elevenlabs.io/">ElevenLabs</a>에서 10개의 한국어 음성을 선정하여 TTS로 음성 데이터를 생성했다. 최종적으로 18K개의 (한국어 음성 질의, 텍스트 tool call) 쌍을 만들었다.</p> <p>예를 들어 이런 식이다:</p> <div class="fc-example"> <span class="input-label">🎤 Input (한국어 음성)</span><br/> "서울 강남구 날씨 어때?"<br/> <span class="arrow">↓ Sori-4B-FC</span> <span class="output-label">📝 Output (텍스트)</span><br/> <span class="tool-call">get_weather({"location": "서울 강남구"})</span> </div> <div class="fc-example"> <span class="input-label">🎤 Input (한국어 음성)</span><br/> "내일 오전 10시에 회의 잡아줘"<br/> <span class="arrow">↓ Sori-4B-FC</span> <span class="output-label">📝 Output (텍스트)</span><br/> <span class="tool-call">create_event({"title": "회의", "date": "tomorrow", "time": "10:00"})</span> </div> <p>한국어 음성이 들어가면 텍스트로 된 structured tool call이 나온다. STT → LLM → Function Call 파이프라인 없이 <strong>end-to-end</strong>로.</p> <h2 id="훈련-과정">훈련 과정</h2> <p>8대의 H100 80GB로 훈련했다.</p> <h3 id="stage-1--alignment">Stage 1 — Alignment</h3> <div class="loss-section"> <img src="/assets/img/sori/train_loss_4b.png" alt="Stage 1 Training Loss"/> </div> <p>처음 2,000 스텝 동안은 loss가 3 근처에서 큰 변화 없이 머문다. audio_proj가 아직 음성 공간과 텍스트 공간의 관계를 못 찾은 거다. 그러다 2k 스텝 즈음에서 <strong>급격하게 떨어진다</strong>. 마치 “아, 이 음성 벡터가 이 텍스트에 대응하는 거구나!” 하고 갑자기 깨달은 것처럼. 이후로는 1 이하로 안정적으로 수렴한다. 6,000 스텝, 12M 파라미터만 학습하는 건데 이 정도면 alignment가 꽤 빠르게 이루어지는 셈이다.</p> <p>솔직히 처음에는 “고작 12M 파라미터로 되겠어?” 싶었다. 4.7B 모델에서 0.25%만 학습하는 건데. 근데 loss가 이렇게 떨어지는 걸 보면서 확신이 생겼다. Audio Encoder와 LLM이 이미 각자의 영역에서 충분히 강력하니까, 둘을 연결하는 다리만 잘 놓으면 되는 거였다.</p> <h3 id="stage-2--function-calling">Stage 2 — Function Calling</h3> <div class="loss-section"> <img src="/assets/img/sori/train_loss_fc.png" alt="Stage 2 Training Loss"/> </div> <p>Stage 2는 더 극적이다. 350 스텝(5 에폭)밖에 안 되는데, 초반 loss 2.5에서 거의 즉시 0.1~0.2 수준으로 떨어진다. Stage 1에서 이미 음성 이해 능력이 갖춰진 상태이고, Qwen3-4B 자체가 tool use를 할 줄 아는 모델이라 LoRA로 살짝 방향만 잡아주면 되는 것이다.</p> <h2 id="결과">결과</h2> <video controls="" style="display: block; margin-left: auto; margin-right: auto; width: 80%; border-radius: 12px;"> <source src="/assets/video/sori/demo.mp4" type="video/mp4"/> </video> <p><em>Sori 데모 영상</em></p> <audio controls="" style="display: block; margin-left: auto; margin-right: auto; width: 80%; margin-top: 16px;"> <source src="/assets/video/sori/weather.mp3" type="audio/mpeg"/> </audio> <p><em>날씨 질의 음성 예시 (ElevenLabs TTS)</em></p> <p>모델은 HuggingFace에 공개해두었다:</p> <ul> <li><a href="https://huggingface.co/Seungyoun/Sori-4B-Base">Seungyoun/Sori-4B-Base</a> — Stage 1 alignment checkpoint</li> <li><a href="https://huggingface.co/Seungyoun/Sori-4B-FC">Seungyoun/Sori-4B-FC</a> — Function Calling 모델</li> </ul> <h2 id="마치며">마치며</h2> <p>이번 실험을 통해 알게 된 것들:</p> <ul> <li>한국어 음성 <strong>410만 샘플, 6,000 스텝</strong>이면 기본적인 alignment가 가능하다</li> <li>Projection layer 12M 파라미터만으로도 음성-텍스트 정렬은 충분히 학습된다</li> <li>Loss 곡선에서 <strong>2k 스텝 부근의 phase transition</strong>이 관찰된다 — alignment가 갑자기 일어나는 순간이 있다</li> <li>Function Calling은 LoRA 350 스텝이면 충분하다 — base LLM의 tool use 능력이 이미 있으니까</li> </ul> <p>물론 한계는 있다. 아직 실시간 스트리밍은 안 되고, 음성의 감정이나 톤을 활용하는 것도 추후 과제다. 하지만 한국어 Speech LLM의 훈련 다이나믹스에 대한 감을 잡을 수 있었고, <strong>데이터 규모 대비 어디까지 가능한지</strong>에 대한 하나의 데이터 포인트를 남길 수 있었다고 생각한다.</p> <p>코드와 모델은 모두 공개되어 있으니 관심 있으면 직접 돌려보시길.</p>]]></content><author><name>신승윤</name></author><category term="speech-llm"/><category term="sori"/><summary type="html"><![CDATA[Qwen3-4B에 Audio Encoder를 붙여 한국어 Speech LLM을 만든 과정]]></summary></entry><entry><title type="html">Mixture of Experts LLM (MoE)</title><link href="https://seungyounshin.github.io/blog/2023/MoE/" rel="alternate" type="text/html" title="Mixture of Experts LLM (MoE)"/><published>2023-12-30T00:00:00+09:00</published><updated>2023-12-30T00:00:00+09:00</updated><id>https://seungyounshin.github.io/blog/2023/MoE</id><content type="html" xml:base="https://seungyounshin.github.io/blog/2023/MoE/"><![CDATA[<h2 id="moe가-왜-필요한가">MoE가 왜 필요한가?</h2> <p>Transformers 구조에서 메모리와 시간복잡도 모두 Attention 구조의 착안하여 증가한다. 그렇기 때문에 LLM에서 Self Attention 이 연산에서 큰 부분을 차지한다고 생각하기 쉽다. 하지만 <strong>실제 파라미터 수가 더 많고 연산에 꽤 많은 부분을 차지하는것은 Feed Forward Network</strong> 부분이다.</p> <p><a href="https://huggingface.co/meta-llama/Llama-2-13b">LLama2-13B</a> 의 <code class="language-plaintext highlighter-rouge">LlamaDecoderLayer</code>은 Self Attention 과 MLP (Feed Forward) 두개로 나누어져 있고 각각 파라미터 수를 계산하면 다음과 같다.</p> <table> <thead> <tr> <th style="text-align: center">LLama2-13B</th> <th style="text-align: center">LlamaAttention</th> <th style="text-align: center">LlamaMLP</th> </tr> </thead> <tbody> <tr> <td style="text-align: center">13.02B</td> <td style="text-align: center">4.19B</td> <td style="text-align: center"><strong>8.49B</strong></td> </tr> </tbody> </table> <p>이와 같이 Llama 에서 MLP 가 Attention의 모든 query,key,value 파라미터 보다도 <strong>2배</strong> 가까이 많은것을 알 수 있다.</p> <p>즉, Attention 보다도 <strong>Feed Foward</strong> 레이어를 최적화하는것이 전체적인 throughput 향상에 도움이 될 수 있다.</p> <h2 id="mixtral-8x7b">Mixtral 8x7B</h2> <p>그렇다면, MoE 로 핫한 Mistral 은 어떤가? <a href="https://mistral.ai/news/mixtral-of-experts/">Mistral 8x7B</a> 도 똑같이 구해보자.</p> <table> <thead> <tr> <th style="text-align: center">Mistral 8x7B</th> <th style="text-align: center">MixtralAttention</th> <th style="text-align: center">MixtralMoeBlock</th> </tr> </thead> <tbody> <tr> <td style="text-align: center">46.70B</td> <td style="text-align: center">1.34B</td> <td style="text-align: center"><strong>45.10B</strong></td> </tr> </tbody> </table> <p>Mistral 의 경우 MixtralMoeBlock 의 8개의 Experts 가 파라미터가 MistralAttention 보다 무려 <strong>33배</strong>가 많다. 실제 여기서 2개의 Expert 를 사용하니 Inference 자체에 사용되는 양은 $33/4 \approx 8$ 배 정도일것이다.</p> <p>물론 Mixtral 8x7B 는 조금 다른 방식의 Scaling 을 쓰고있다.</p> <p>우선, <a href="https://arxiv.org/pdf/2001.08361.pdf">Scaling Laws for Neural Language Models</a> 논문의 e.q:2.1 을 보면,</p> \[d_{\text{attn}} = d_{\text{ff}}/4 = d_{\text{model}}\] <p>위 와 같이 Feed Foward 의 중간 차원 $d_{\text{ff}}$ 은 전체 모델 및 Attention 의 차원 $d_{\text{attn}}, d_{\text{model}}$ 에 1/4 가 되게 설정한 채로 Scaling 을 진행한다.</p> <p>Llama2 와 Mixtral 8x7B의 $d_{\text{ff}}/d_{\text{model}}$ 를 계산해보자.</p> <table> <thead> <tr> <th style="text-align: center">Model</th> <th style="text-align: center">$d_{\text{ff}}$</th> <th style="text-align: center">$d_{\text{model}}$</th> <th style="text-align: center">$d_{\text{ff}}/d_{\text{model}}$</th> </tr> </thead> <tbody> <tr> <td style="text-align: center"><a href="https://arxiv.org/pdf/2001.08361.pdf">Kaplan et al.</a></td> <td style="text-align: center">-</td> <td style="text-align: center">-</td> <td style="text-align: center">4</td> </tr> <tr> <td style="text-align: center">Llama2 13B</td> <td style="text-align: center">13824</td> <td style="text-align: center">5120</td> <td style="text-align: center">2.7</td> </tr> <tr> <td style="text-align: center">Mixtral 8x7B</td> <td style="text-align: center">14336</td> <td style="text-align: center">4096</td> <td style="text-align: center">3.5</td> </tr> </tbody> </table> <p>하지만 Mixtral 의 경우 Query 와 Key Projection 의 Output 차원이 다르므로 Query Output Dimension 을 기준으로 계산하였다. 결과적으로는 Mixtral 도 $d_{\text{ff}}/d_{\text{model}}$ 가 3.5 로 4보다 작다.</p> <p>Llama2와 확연히 다른점은 Attention 쪽 파라미터가 더 작으면서 (Llama2-13B는 4.19B, Mixtral 8x7B 은 1.34B) Feed Forward 의 $d_{\text{ff}}$ 를 Scaling 한 것이다. 이러한 구조를 통해 Llama2 보다 더 좋은 성능을 낸다고 리포트하고 있다.</p> <p><img src="/assets/img/mixtral_perf.png" alt="Mixtral Performance" style="display: block; margin-left: auto; margin-right: auto; width: 80%;"/></p> <p>이 Figure 가 가장 전반적인 성능을 볼 수 있는 것 같아 가지고 왔다. Mixtral 8x7B는 Active Paramater 가 12B (실제 2개의 Experts만 선택을 하니까) 인데 대충 Llama13B와 비교해도 성능이 높고 70B보다도 좋다는것을 강조하고 싶었던것 같다.</p> <p>Mixtral 8x7B가 전체 Param 이 46B 정도인데 70B Llama2 보다 <strong>Code, Math 같이 Reasoning</strong> 이 많이 필요한 곳에서도 월등히 잘하는것은 결과에 조금 의구심이 들기도한다. 물론 CodeLlama 가 Code 부분에서 더 잘하는것을 생각해보면 벤치마킹을 위해 데이터셋을 보강하고 집중적으로 훈련시키면 불가능한 부분은 아니라는 생각이 들긴한다.</p> <p>몇가지 더 궁금한 점은</p> <ul> <li>우선, <strong>모든 Experts 를 다 쓰도록</strong> Inference 하면 성능이 더 떨어지는지</li> <li>Knowledge, MATH, Code … 각기 다른 벤치마크에서 MoE의 <strong>특정 Experts 가 계속 선택</strong>이 되는지가 조금 궁금하다.</li> </ul> <p>그런데 그런 실험 결과를 리포트하지 않은것을 보면 어쩌면 Experts 를 다 쓰게하면 성능이 떨어지는것이 아닐까 싶다. 혹시나 해서 🤗HF 의 <a href="https://huggingface.co/mistralai/Mixtral-8x7B-Instruct-v0.1/discussions?status=open">discussions</a> 를 찾아보았는데 Experts 를 다 쓰는 경우에 대한 성능리포트를 대신 해준 사람은 없는것 같다.</p> <h2 id="routing-analysis">Routing Analysis</h2> <p><a href="https://arxiv.org/pdf/2401.04088.pdf">Mixtral of Experts</a> 라는 제목으로 논문이 공개가 되었고 위의 두번째 질문 (“Knowledge, MATH, Code 등 각기 다른 벤치마크에서 MoE의 <strong>특정 Experts 가 계속 선택</strong>이 되는지가 조금 궁금하다. “) 에 대해서 <strong>Routing Analysis</strong> 에서 분석하고 있어 관련 내용을 정리해보았다.</p> <p><img src="/assets/img/mixtral_fig7.png" alt="Figure 7" style="display: block; margin-left: auto; margin-right: auto; width: 80%;"/></p> <p><a href="https://arxiv.org/abs/2101.00027">Pile</a> 데이터셋에서 전체 시퀀스를 넣고 각각 도메인 (Arxiv, Github 등등) 에서 각각 Experts 들이 얼마나 Selection 되는지를 정리한 도식이다. 회색 dash line 이 1/8 이어서 이 회색선 위에 위치한것은 그만큼 많이 선택된 Experts 라는 것이다. 수학($\texttt{DM Mathematics}$) 는 31번째 Layer 에서 압도적으로 0번 Expert 에 의해 선택된것을 확인해볼 수 있다. 반대로 똑같이 31번째 Layer 에서 언어가 좀더 많은 데이터셋인 $\texttt{StackExchange},\texttt{Wikipedia}$ 에서는 8번째 Expert가 선택된것도 재밌다. 또 0번째 Layer 에서는 비교적 균등하게 선택되다가 Layer 가 점점더 깊이 올라올 수록 특정 도메인에 특정 Expert 가 더 많이 선택되는 결과도 재밌다.</p>]]></content><author><name>신승윤</name></author><category term="distill"/><category term="formatting"/><summary type="html"><![CDATA[요즘 핫한 MoE 에 대해 알아보자.]]></summary></entry><entry><title type="html">LLM이 스스로 발전할 수 있을까?</title><link href="https://seungyounshin.github.io/blog/2023/SelfImprovingLLM/" rel="alternate" type="text/html" title="LLM이 스스로 발전할 수 있을까?"/><published>2023-12-30T00:00:00+09:00</published><updated>2023-12-30T00:00:00+09:00</updated><id>https://seungyounshin.github.io/blog/2023/SelfImprovingLLM</id><content type="html" xml:base="https://seungyounshin.github.io/blog/2023/SelfImprovingLLM/"><![CDATA[<h2 id="draft">Draft</h2> <h3 id="self-correction">Self Correction</h3> <p><a href="https://ar5iv.labs.arxiv.org/html/2303.11366"><strong>Reflexion</strong></a></p> <p>너무나도 유명한 논문이다. 이전에 틀렸으면 다시 반추(Reflection) 하면 원래 결과보다 계속 잘해지게 된다는 내용인데 현실적으로는 적용하기 어렵다. 왜냐하면, 우선 해당 논문에서는 Oracle Feedback 을 받는다. 예를 들어 HumanEval 과 같은 코딩문제에서는 Programming Judge 로 부터 맞았는지 틀렸는지를 알수가 있다. 밑에 <strong>Large Language Models Cannot Self-Correct Reasoning Yet</strong> 에서는 이런 Error Singal 을 흘려주는 것은 진정한 Self Correction이 아니라고 말하고 있고 나도 이 주장이 상당히 신빙성이 있다고 느껴진다. 하지만, 처음 Reflection 이라는 개념을 제안했다는 측면에서 꽤 의미 있는 논문인것 같다. 여담이지만 Neuirps 에 갔을 때 포스터에 저자가 와서 물어봤었다 ㅎㅎ 저자도 뭔가 다음 스텝을 생각하는 느낌이었다. 왜냐면 결국 성능이 Saturated 된다. 특정 성능 이상은 모델의 개별성능을 넘을 수 없다는것이다. 인간도 계속 생각하다 보면 어떤 문제는 풀 수 있지만 그래도 어떻게든 못푸는 문제가 존재하는것과 동일하다고 생각이된다.</p> <p><a href="https://arxiv.org/abs/2310.01798"><strong>Large Language Models Cannot Self-Correct Reasoning Yet</strong></a></p> <p>몰랐는데 이 논문이 ICLR2024에 Submit 되었다 결과는 어떻게 될지 모르겠지만 이 당시에는 Self Correction 하는 방법론들이 우후죽순 나오고있던 때라 Self Correction 이 단순히 Accuracy 가 올라가는것만 보면안되고 맞았다가 틀려진 것과 틀렸는데 맞아진것을 같이 보면 결국은 LLM이 아직은 Self Correcting 을 못한다는 내용이다. 근데 실제 해보면 논문의 말처럼 맞았는데 틀려지는게 꽤 된다.</p> <h3 id="synthetic-data-self-training">Synthetic Data Self-Training</h3> <p><a href="https://cdn.openai.com/papers/weak-to-strong-generalization.pdf"><strong>weak to strong(OpenAI)</strong></a></p> <p>많은 사람들이 대체 왜 그냥 Strong 모델을 훈련시키기 않냐고 비난을 받는 논문인데. 그치만 가만 생각해보면 이 세팅은 다른 어떤 논문보다 Synthetic data 를 진지하게 다루고 있다고 생각한다. 절대 이 논문의 세팅은 strong 모델을 제한하려는 방향이 아니다. weak LLM의 아웃풋 (즉, 사람이 될수도 있다) 을 가지고 이것을 $P_\text{data}$ 로 이용한다면, 결국 SFT를 하든 뭐를 하든 Global Maximum 인 사람 그 자체를 넘어서지 못한다. 근데 해당 논문에서는 이를 넘어설수 있음을 보였다. 하지만 아직 오점이 많다. 논문에서 이야기하는 strong LLM 이 사람을 넘어서는 것은 아니다 ($\texttt{MMLU} \le 90\%$) 즉, 사람을 넘어서는 아주 새로운 synthetic data가 아니라 $P_\text{data}$ 를 가지고 훈련된 underfitting 된 모델 끼리의 weak-to-strong 을 논의하고 있다.</p> <p><a href=""><strong>Reinforced Self-Training (ReST) for Language Modeling</strong></a></p> <p>Grow Step 과 Improving Step 으로 나뉘어 스스로 성장하는 LLM을만드는것인데 translation 에서만 실험을 한것이 아쉽다.</p> <p><a href="https://ar5iv.labs.arxiv.org/html/2308.08998"><strong>Beyond Human Data: Scaling Self-Training for Problem-Solving with Language Models</strong></a></p> <p>사람을 넘기위해서는 사람의 데이터를 모사하면 안됨. Synthetic Data 를 만들고 Scalar Feedback 을 만들어서 이걸 가지고 단순히 MMLU나 TriviaQA와 같은 언어쪽 도메인이 아니라 정말 Reasoning 이 필요한 MATH, Code(APPS, HumanEval) 에서의 정확도 향상을 보이는 논문임.</p> <p><a href="https://ar5iv.labs.arxiv.org/html/2310.10047"><strong>Improving Large Language Model Fine-tuning for Solving Math Problems</strong></a></p> <p>Pass@1 하고 Pass@K 즉 LLM 에서 여러번 Sampling 하면 성공하는 비율과 단번에 풀어버리는 비율이 수학이나 코딩쪽에서 꽤 많이 차이가 난다. 이걸 개선하는 논문인듯</p> <p><a href="https://arxiv.org/abs/2401.01335"><strong>Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models</strong></a></p> <p>RL로 LLM을 튜닝하는 방법은 Preference 를 필요로한다. SFT 세팅에서 같은 모델($\theta$)를 Generator, Discriminator로 생성해보고 $P_\text{data}$ 인 보통은 인간이나 GPT4가 생성한 데이터와 가까워지고 본인이 이전에 생성한것 과는 멀어지는 방향으로 학습하게된다. 수학적 수식을 통해 훈련 Loss 를 간단하게 도출한 점이 매우 훌룡한 것 같다.</p>]]></content><author><name>신승윤</name></author><category term="distill"/><category term="formatting"/><summary type="html"><![CDATA[dd]]></summary></entry><entry><title type="html">dataclasses — 데이터 클래스</title><link href="https://seungyounshin.github.io/blog/2023/python-dataclass/" rel="alternate" type="text/html" title="dataclasses — 데이터 클래스"/><published>2023-12-23T06:01:00+09:00</published><updated>2023-12-23T06:01:00+09:00</updated><id>https://seungyounshin.github.io/blog/2023/python-dataclass</id><content type="html" xml:base="https://seungyounshin.github.io/blog/2023/python-dataclass/"><![CDATA[<p>프로그래밍에서 <code class="language-plaintext highlighter-rouge">interface</code>를 잘 설계하는 것은 코드의 가독성과 유지 보수성을 높일 수 있다.</p> <p>Python 3.7 이상에서 사용할 수 있는 <code class="language-plaintext highlighter-rouge">dataclass</code>는 데코레이터를 통해 클래스 선언을 간소화할 수 있는데 또한 <code class="language-plaintext highlighter-rouge">interface</code> 로서의 역할에도 매우 좋다. 요즘 유행하는 <a href="https://docs.pydantic.dev/latest/">pydantic</a>도 이런 dataclass 에 validation 을 할 수 있는 패키지중 하나이다.</p> <h2 id="dataclass의-기본-사용법">Dataclass의 기본 사용법</h2> <p>C++의 구조체와 유사한 방식으로, Python에서도 간단한 데이터 구조를 빠르게 정의할 수 있는데 x,y 를 가지는 <code class="language-plaintext highlighter-rouge">Point</code> 클래스의 예를 만들어보자.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">dataclasses</span> <span class="kn">import</span> <span class="n">dataclass</span>

<span class="nd">@dataclass</span>
<span class="k">class</span> <span class="nc">Point</span><span class="p">:</span>
    <span class="n">x</span><span class="p">:</span> <span class="nb">float</span>
    <span class="n">y</span><span class="p">:</span> <span class="nb">float</span>
</code></pre></div></div> <p><code class="language-plaintext highlighter-rouge">dataclass</code> 데코레이터는 <code class="language-plaintext highlighter-rouge">__init__</code>, <code class="language-plaintext highlighter-rouge">__repr__</code>, <code class="language-plaintext highlighter-rouge">__eq__</code> 등의 메서드를 자동으로 추가해준다. 그렇기 때문에 인스턴스를 출력하면</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="o">&gt;&gt;&gt;</span> <span class="nf">print</span><span class="p">(</span><span class="nc">Point</span><span class="p">(</span><span class="mi">3</span><span class="p">,</span><span class="mi">4</span><span class="p">))</span>
<span class="nc">Point</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">y</span><span class="o">=</span><span class="mi">4</span><span class="p">)</span>
</code></pre></div></div> <p>다음과 같이 깔끔하게 포맷된 결과가 출력된다.</p> <h2 id="transformers-예시"><code class="language-plaintext highlighter-rouge">transformers</code> 예시</h2> <p>오픈소스 모델들을 쉽게 이용할 수 있는 레포인 <a href="https://github.com/huggingface/transformers">transformers</a> 에서도 <code class="language-plaintext highlighter-rouge">Argument</code> 와 모델의 인풋 아웃풋와 같은 interface 를 모두 <code class="language-plaintext highlighter-rouge">dataclass</code> 로 정의해서 사용하고있다.</p> <p>예를 들어 거의 모든 언어모델들의 아웃풋은 <a href="https://github.com/huggingface/transformers/blob/29e7a1e1834f331a4916853ecd58549ed78235d6/src/transformers/modeling_outputs.py#L25"><code class="language-plaintext highlighter-rouge">BaseModelOutput</code></a>를 상속해서 쓰는데 <code class="language-plaintext highlighter-rouge">BaseModelOutput</code> 를 보면</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@dataclass</span>
<span class="k">class</span> <span class="nc">BaseModelOutput</span><span class="p">(</span><span class="n">ModelOutput</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">
</span><span class="gp">    ...</span>
    <span class="sh">"""</span>

    <span class="n">last_hidden_state</span><span class="p">:</span> <span class="n">torch</span><span class="p">.</span><span class="n">FloatTensor</span> <span class="o">=</span> <span class="bp">None</span>
    <span class="n">hidden_states</span><span class="p">:</span> <span class="n">Optional</span><span class="p">[</span><span class="n">Tuple</span><span class="p">[</span><span class="n">torch</span><span class="p">.</span><span class="n">FloatTensor</span><span class="p">]]</span> <span class="o">=</span> <span class="bp">None</span>
    <span class="n">attentions</span><span class="p">:</span> <span class="n">Optional</span><span class="p">[</span><span class="n">Tuple</span><span class="p">[</span><span class="n">torch</span><span class="p">.</span><span class="n">FloatTensor</span><span class="p">]]</span> <span class="o">=</span> <span class="bp">None</span>

</code></pre></div></div> <p>와 같이 <code class="language-plaintext highlighter-rouge">BaseModelOutput</code> 의 아웃풋은 보통의 <code class="language-plaintext highlighter-rouge">transformer</code> 구조에서 나올 수 있는 아웃풋들을 포함하는것을 알 수 있다. 이런식으로 Interface 를 datalcass 로 설계하면 우선 코드가 매우 간결해진다. 만약 ABC 클래스로 부터 이런 interface 를 만든다고 한다면 <code class="language-plaintext highlighter-rouge">__init__</code> 부터 여러가지 설계해야할점이 너무나 많고 코드가 방대해진다.</p>]]></content><author><name></name></author><category term="python"/><summary type="html"><![CDATA[an example of a blog post with some code]]></summary></entry></feed>